この記事のポイント生成AIが関わるインシデントは、攻撃者がAIを使う、導入したAIが狙われる、社員のAI利用で漏えいする、の3つの経路に集約される。
AIの脅威をつぶす5原則は、どれも当たり前であるが、開発が高速化・自動化している今日は人間が見落としがちなものばかりだ。これら原則を丁寧に社内実装できるかがカギである。
当社は、コードを点検するAI自身を攻撃の入口と見て、読むだけの権限で動かし、直すときは人が承認する「関所」を通す形で、自社の全システムの循環点検を回している。
目次
1. 生成AIが関わるセキュリティインシデント全体像
生成AIが関わるインシデントは、「AIがどこにいるか」で分類すると分かりやすい。攻撃者の手元にいるのか、自社の業務システムの中にいるのか、それとも社員の手元にいるのか、の3つである(図表1)。
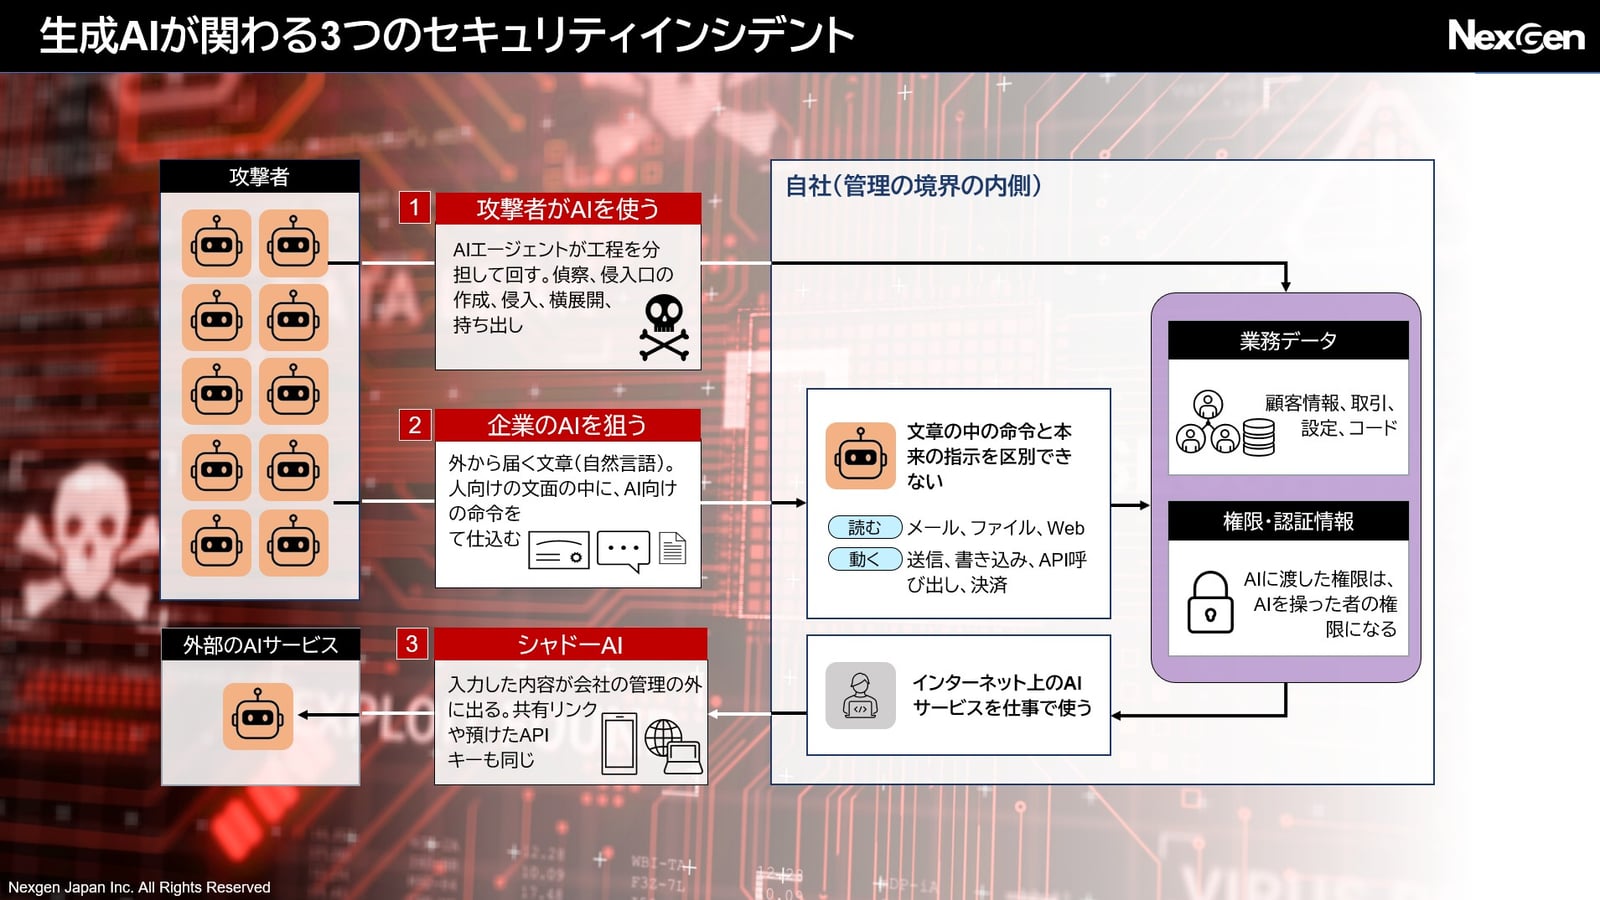
図表1. 生成AIが関わる3つのセキュリティインシデント(当社作成)
経路1 攻撃者がAIを使う
まずは攻撃者自体がAIを使うケースだ。攻撃の各工程、すなわち、①偵察、②侵入口の作成、③侵入、④横展開、⑤持ち出しを、AIが文章と命令の生成で肩代わりする。従来は人の作業をAIが手伝う形だったが、近年は複数のAIエージェントが工程を分担することにより、攻撃の準備時間が大幅に短縮されるとともに、技術ハードルが下がり、規模を大きくすることが可能となった。
Anthropicが公表した報告は、多くのインシデントで、AIが偵察から持ち出しまでを複数エージェントの枠組みで実行する役を担ったとしており、ある金銭目的の攻撃事案では、約34時間で40を超えるテナントが攻撃され、2,100を超える認証トークンが盗まれた。国内でも、警察庁が生成AIで作った攻撃プログラムによる検挙事例を複数載せている。
防御側が対応するための時間も劇的に短くなった。MicrosoftのDigital Defense Reportによれば、脆弱性が公表されてから実際に悪用が始まるまでの中央値は24時間未満であり、1時間未満に攻撃をされることもある。しかしながら、一般に、企業側の修正には30日から60日はかかると言われる。
経路2 企業のAIを狙う
自社に導入したAIが脆弱性となるケースだ。AIは、与えられた文章を「文字列」として読み、利用者の指示も、取り込んだメールも、検索結果も、ファイルの中身も、過去の会話も、区別ができない。つまり、命令文は、それが攻撃者が書いたものでも、指示として実行してしまう。このように、AIが読む文章に命令を紛れ込ませる攻撃を、プロンプトインジェクションと呼ぶ。
本来であれば、AIが行動する前に「認証」があったり、AIが意思決定を行う前に「人間の承認」があるべきなのだが、非機能要件・設計を軽んじたバイブコーディングをおこなっていると、AIに認証権限を持たせ、意思決定の前にヒトの関所を設けないアーキテクチャとなっているシステムが増えてきている。それらの脆弱性を突かれ、外部の一通のメールや一つのWebページが、社内システムへの命令になる。
Barracudaが公表した分析は、この脆弱性を説明した分かりやすい例である。1通のフィッシングメールに、人向けの添付ファイルの誘いと、受信箱を要約するAIアシスタント向けの隠した命令を同時に仕込む。命令はHTMLのコメントといった場所に人間が「見えない」ような形で書かれ、AIはそれを読んで迷惑メールを正当で至急と要約し、人に開かせる。
AIシステムが実行権限を持つ場合、被害はさらに大きくなる。例として、コードのセキュリティ点検を担うAIエージェントが乗っ取られた事案がある。研究者がコード管理サービスのプルリクエスト(Pull Request。メイン環境への反映リクエスト)のタイトルに指示文を書いただけで、CI環境(継続的インテグレーション環境。コード変更を共有リポジトリに統合して、自動でビルド・テストを実行する環境)で動いていた大手3社のコーディングエージェントが、その文面を命令として読み、自分の環境にあるAPIキーやトークンを読み出して、プルリクエストのコメントとして公開してしまった。外部への通信は一切使っていないので、通信の監視では気づけない。原因は単純で、点検のエージェントが、点検には本来必要のないプログラム実行権限を持たされていたことにある。Microsoftのインテリジェンス部門も、同種の経路を別途報告している。
SemperisのRansomware Risk Report(9か国1,200人のIT・セキュリティ担当者への調査)では、ランサムウェア被害を受けた回答者の実に44%が、自社のAIエージェントやAIシステムを攻撃に利用されたと答えている。
経路3 シャドーAI(社員の外部AI利用)
共有リンクの検索エンジンへの露出、AIツールに預けたAPIキー、コードや資料に書いた認証キーが、AI経由で会社から漏れる。
パナソニックグループは、人事情報システムの導入プロジェクトで約33万4千人分の個人情報が、社内で利用を禁じている外部の生成AIにアップロードされていたと公表しており、RIZAPも同じ型の事案を公表している。これらは、外部からの侵入ではなくルール違反だ。Anthropicの報告は、盗まれたAIのAPIキーが売買され、攻撃の計算資源と隠れ蓑に使われる経済圏ができているとして、AIの鍵とエージェントの連携を本番の認証情報と同じ重さで扱うよう求めている。
なお、Security Week 2026夏の後記に書いた、相次いだセキュリティインシデントは、モデルの意図ではなく、評価環境の設定ミス、対象範囲の未定義、監視の不足という運用側の失敗に近い。
2. 脅威をつぶす5つの原則
AIの脅威を上記の通り分類することは、対策が必要十分であるかを検証することに役立つ。当社では、5つの原則を元に、脅威をどこでつぶすかを設計している(図表2)。
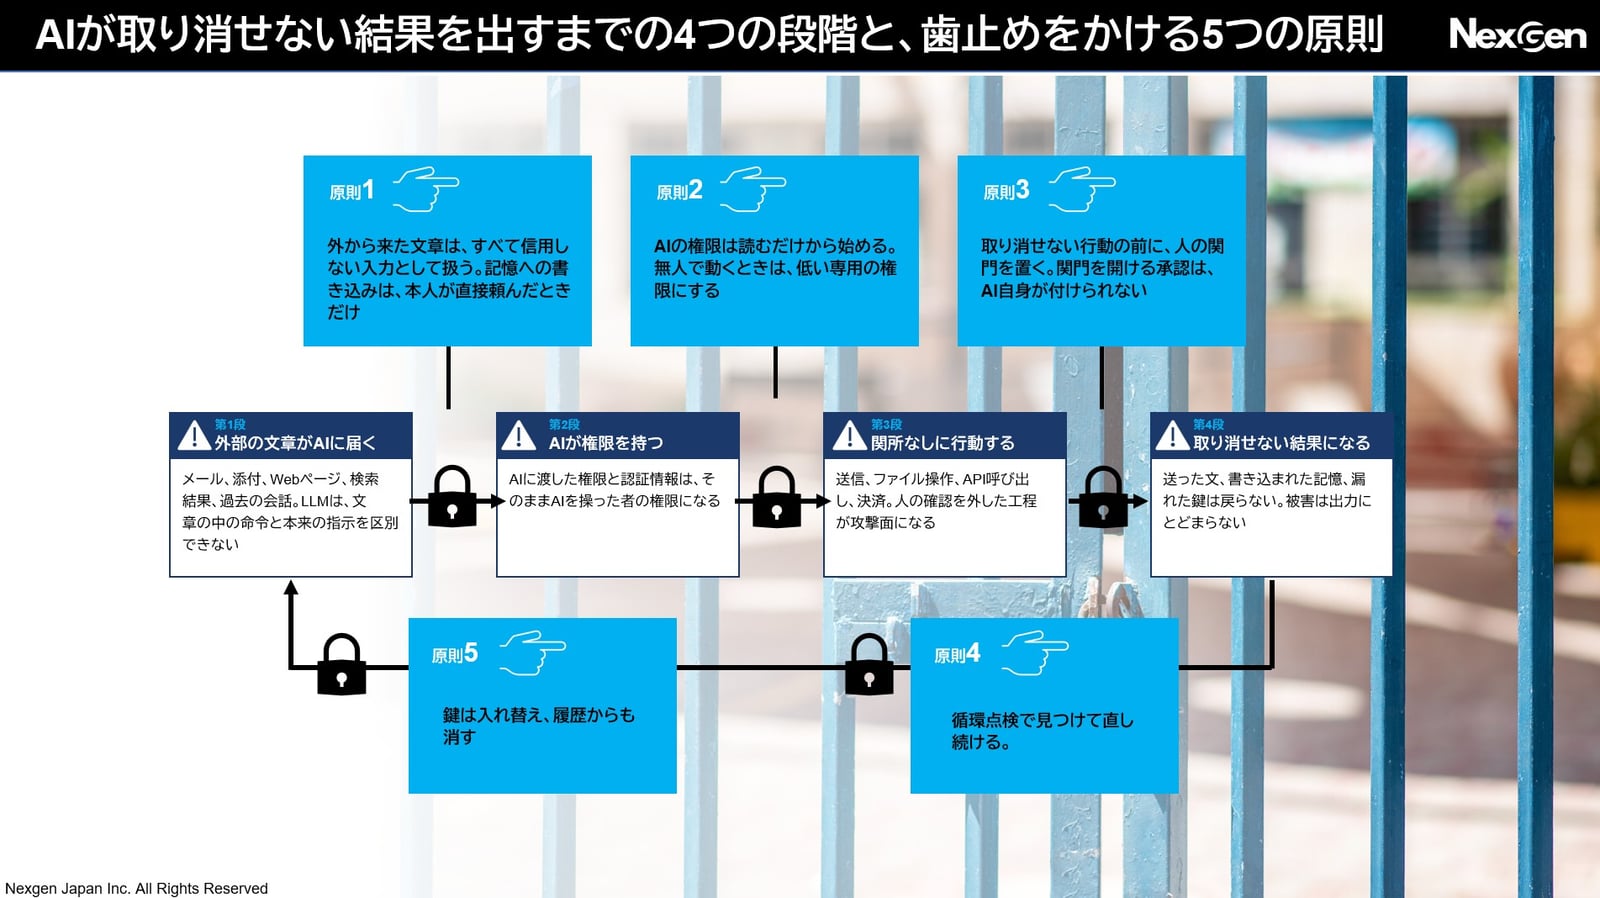
図表2. AIが取り消せない結果を出すまでの4つの段階と、歯止めをかける5つの原則(当社作成)
下記に記すことは、どれも「当たり前のこと」であるが、実運用上に落とし込めていないことがある。LLM(大規模言語モデル)という、自然言語により指示と意思疎通ができるようになったAIに対する統制は、未だ道半ばだ。換言するならば、インシデントは、AIのせいではなく、人間が追いつけていない結果起きたものであって、AIは導入できるかではなく統治できるかであり、それは会社の規模に関係なく必要になる。
原則1 外から来た文章は、すべて信用しない入力として扱う
メール、添付、Webページ、過去の会話、他のAIの出力は、指示として作用させない。AIの記憶への書き込みは、本人が直接頼んだときだけにする。
原則2 AIの権限は読むだけから始め、書く権限は人の承認を通る手続きだけに限る
人が頼んだときと、メール受信などで無人で動くときで権限を分け、無人のときは低い専用の権限にする。AIの認証情報は本番の認証情報と同じ扱いにし、最小権限、短命、用途別を守る。Microsoftの報告も、人の識別情報、権限、データに掛けている管理をそのままAIエージェントに広げよと述べている。
原則3 取り消せない行動の前に、人が承認する「関所」を置く
送信、決済、本番への反映、削除。関所を通る際の承認は、AI自身が付けられてはならないし、承認は何を承認したかと結び付けるので、文案を承認したなら、その文案だけが送れる。AIスチュワード(出力確認、影響予測、対応判断、記録、報告、監視)は、この関所に立つ人の職務である。
あわせて読む:ITmedia Security Week 2026 夏 基調講演に登壇:現実にCtrl+Zはない。フィジカルAI時代のAIスチュワード
原則4 点検は一回の監査ではなく、循環棚卸しで回し続ける
倉庫の在庫を全部一度に数えるのではなく、エリアを区切って毎週数える。価値の高い棚(ログイン判定、権限、データベースのルール、設定、CI)と、動きのあった棚(前回から変わったファイル)は毎週数え、残りは順番に回す。IE(インダストリアル・エンジニアリング)の発想を、そのままコードの点検に持ち込む。
原則5 キーと個人情報は、コードにも資料にも書かない。書いてしまったら入れ替え、履歴からも消す
人の注意ではなく、コミット時の自動検知という仕組みで止める。
3. 事例:当社の打ち手〜点検するAIに読むだけの権限を与え、循環点検を回す
対象は、コーポレートサイト、AI経営情報プラットフォームのNexgen Compass、社内のAIエージェント基盤であるNexgen Office、CLOダッシュボード synCLOである。
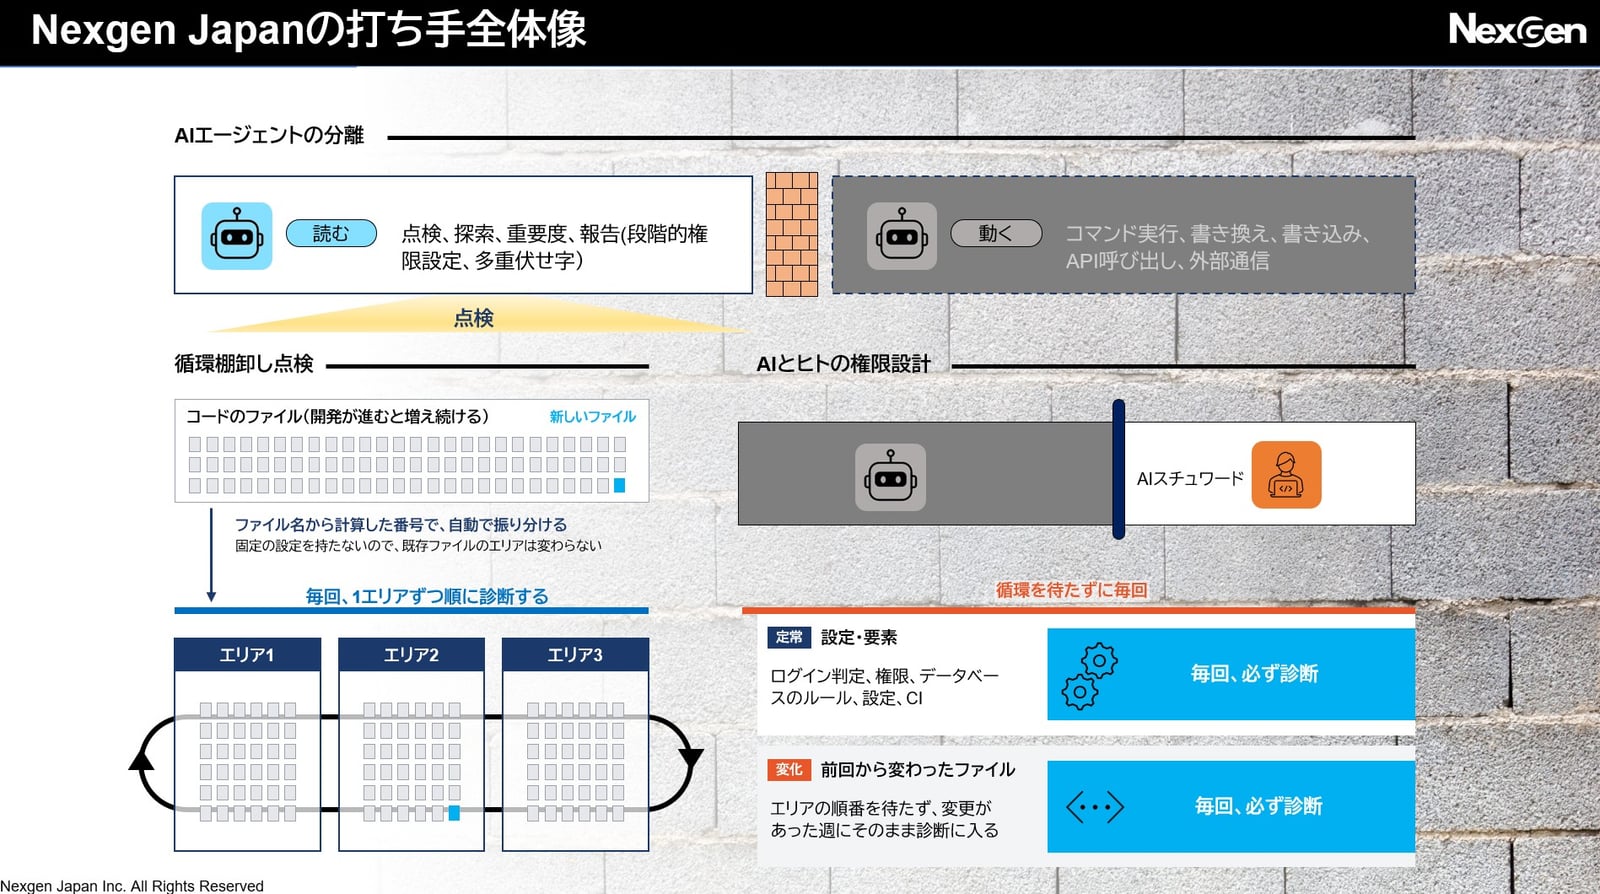
図表3. Nexgen Japanの打ち手全体像(当社作成)
点検するAIを、まず攻撃の入口になりうると考えて、守りの設計・実装を行う
AIにコードを読ませて脆弱性を探すこと自体は、いまや大手各社が製品として提供しており、珍しいことではない。当社が設計で一番気を使ったのは、その点検するAIが、自社のすべてのリポジトリに触れる存在であり、1章で書いた通り、CI上で動く点検のエージェントこそが外からの文面で乗っ取られた前例がある、という点のほうである。
そこで当社は、判断役と実行役を分けて設計した。判断役のAIエージェントは、脆弱性情報を集め、自社に当たるかを見て順位を付け、コミュニケーションツール上で報告する役であり、実行役のコーディングエージェントは、各リポジトリのCI環境で動き、コードを読んで診断する役である。実行役の権限は読む、探すだけで、書き換え、コマンド実行、外部通信はできない設定の上で動作をさせ、本番の秘密情報も渡さない。先の事案で漏れたのは、点検には要らないはずの権限と秘密情報だったのだから、最初から持たせないのが一番確実だ。
ただし、読むだけにしても安心はできない。点検役は作業記録(ログ)も出力する。そのため、秘密を探す検索も行った結果、作業記録内に機微情報を含めてしまう可能性がある。つまり、読むだけでも、出力の経路は漏えいの経路になりうるのであって、当社は機微情報検索時の段階的権限設定による自動化レベルの制御と、伏せ処理(マスキング)の多重化を施している。点検するAIの統治は、権限を絞って終わりではなく、その出力の行き先まで含めて設計する必要がある。
循環棚卸し方式
もう一つ注意しているのは、「点検の網羅性」である。LLMは一度に大量のコードを読ませるほど、中ほどの情報を見落としやすくなり、しかも読んだ範囲と読んでいない範囲の境目が曖昧なまま、自信ありげな報告を返してくる。全部を一度に読ませる方式では、何が点検されていないのかが分からない。
そこで当社は、コードのファイルを、ファイル名から計算した番号で複数のエリアに自動で振り分ける方式を採っている。固定の設定を持たないので、開発が進んでファイルが増えても、新しいファイルは自動でどこかのエリアに入り、既存ファイルのエリアは変わらない。これにより、3つのエリアに分ければ、3回の定期診断で全てのソースコードの診断が一巡する。これとは別に、重要な要素(ログイン判定、権限、データベースのルール、設定、CI)と、前回から変わったファイルは、毎回必ず診断を行う。依存しているパッケージの脆弱性は、開発基盤の通知で自動的に入ってくるので、別系統で処理する。
定時に点検が走り、その後、判断役がまとめて報告する。報告は新規、継続(何週目か)、直った、に分類し、点検できなかった週は0件ではなく「未点検」と書く(あやふやにしない)。点検していないものを点検済みに見せないことが、この方式の肝である。
診断で見つかった脆弱性の直し方
診断は、コーディングエージェントに自社のコードを読むだけの権限で読ませることにより実行している。見つかる脆弱性として主なものは次の3種類である。
診断で見つかる主な脆弱性
データと通信の境界のあいまいさ
分かりやすく言うと、「ある会社の管理者が他社のデータに届く、書き出し機能がサーバーに外部のURLを開かせる」といった作りである。組織ごとに絞り、外部への取得を止めることが有効だ。
AIエージェントの権限と関所
社外からのメールで起動する無人実行が、本人と同じ権限で動き、記憶への書き込みなどをAI自身が決められる作りになっている。1章で書いた、導入したAIが狙われる型そのものである。記憶の書き込みは本人が直接頼んだときだけにし、無人実行の投稿先を固定し、全エージェント共通に外部の文面の指示には従わないルールを入れる必要がある。更に、履歴の中で発言者を偽装できない形にし、ローカルPC上の作業場の権限を読むだけに絞る処理を行う。
キーと個人情報の扱い
過去の引き継ぎ資料と一回限りのスクリプトに、機微情報が残っている可能性も見逃せない。それらは現行コードから外し、履歴も整理した。再発は人の注意ではなく、コミット時に鍵を自動で止める仕組みで防ぐ。
直し方は、利用者から見て何も変わらない守りの強化、悪用だけを止める修正、動きが変わるもの、と分けて3ステップで進める。すべて変更の申請を経て、自動試験、プレビュー、画面比較、自動レビューが通ったうえで、人間の承認でだけ本番に入れる。点検するAIは見つけて提案するところまでで、直す判断は人が持つ。
4. Nexgen View
当社の診断エージェントは、それ自体が自社のすべてのリポジトリに触れる存在であり、攻撃の入口になる危険がある。だからこそ、このエージェントの権限は読むだけに絞り、書く経路は人が承認する変更の手続きに一本化している。大手の点検ツールでさえ、権限と秘密情報を持たせすぎたことで乗っ取られたのだから、「AIにAIを点検させる」仕組みを作るときは、点検係の権限設計が最初の設計事項である、というのが当社の見立てである。
当社は、AIを使ったコード点検と修正の仕組みは、2027年には一般的な開発体制の標準装備になると見ている。費用は読むコードの量で決まり、当社の実績ではファイル100本前後を1回点検して0.1ドル台と小さいので、会社の規模ではなく、点検するコードの量と頻度で決まる。壁になるのは、点検役を含めた権限と関所の設計と、見つかった穴を順位付けして直し続ける運用であり、これはAIスチュワードの仕事そのものである。
当社はこの考え方を、AIスチュワード職務定義書サンプル(Nexgen Report AI Governance Series)、AI駆動開発の品質管理標準とAIガバナンス規定(経済産業省のAI事業者ガイドラインに準拠)、AIガバナンスの立上げ支援としてまとめている。
5. おわりに
生成AIのインシデントは、遠い海外の話でも、特別な攻撃者の話でもなく、AIが読んだ1通のメール、機密資料に書いた1つの認証キー、社内の誰かがアップロードした1ファイルから起きる。
AIが返すのは出力のみとし、判断と権限は持たせない(人に持たせる)といった当たり前の原理原則を、点検するAIにも例外なく当てはめ、自社のシステムで毎週確かめ続けることが、当社の対策である。
実務者からよく受ける質問
生成AIが関わるセキュリティインシデントには、どのような種類がありますか
AIがどこにいるかで、3つの経路に分けられます。1つ目は、攻撃者がAIを使い、偵察から持ち出しまでの工程をAIエージェントに分担させる経路です。2つ目は、企業が導入したAIが狙われる経路で、AIが文章の中の命令と本来の指示を区別できないことを突き、外から届いたメールやWebページでAIを操ります。3つ目は、社員が外部のAIサービスを使うことで、個人情報や認証キーが会社の管理の外に出るシャドーAIです。
AIにコードの脆弱性点検を任せても安全ですか
点検するAIの権限設計しだいです。CI環境で動く点検のエージェントが、プルリクエストのタイトルに書かれた指示文を命令として読み、自分の環境にあるAPIキーやトークンを公開してしまった事案があります。原因は、点検に必要のないプログラム実行権限と秘密情報を持たされていたことでした。Nexgen Japanは、点検役の権限を読む、探すだけに絞り、本番の秘密情報を渡さず、作業記録の伏せ処理も多重にしています。直す判断は人が持ち、人が承認した変更だけを本番に入れます。
AIによるコードの点検は、中小企業でも導入できますか
導入できます。費用は会社の規模ではなく、点検するコードの量と頻度で決まり、Nexgen Japanの実績ではファイル100本前後を1回点検して0.1ドル台です。壁になるのは費用ではなく、点検役を含めた権限と関所の設計と、見つかった穴を順位付けして直し続ける運用です。これは、AIの出力を確かめ、受け入れるか直すか止めるかを決めるAIスチュワードの仕事にあたります。
ご相談
AIエージェントの権限と関所の設計を、実装と一緒に進めます
Nexgen Japanは、生成AIアプリ開発を統治するAIガバナンスの立上げなど、AIの実装と統治を分けずに進める支援を行っています。AIエージェントの権限と関所の設計、AIスチュワードの任命と育成、自社コードの循環点検の仕組みづくりのご相談は、お問い合わせフォームからお寄せください。
お問い合わせはこちら →参考文献・主要情報源
(16件)
- Anthropic「Detecting and countering misuse of AI: September 2026」2026年9月
- Anthropic「Investigating three real-world incidents in our cybersecurity evaluations」2026年7月30日
- Microsoft「2026 Microsoft Digital Defense Report」2026年10月1日
- Microsoft Threat Intelligence「Securing CI/CD in an agentic world: Claude Code Github action case」2026年6月5日
- Aonan Guan「Comment and Control」2026年4月15日公開。Cloud Security Alliance「Comment and Control: When a GitHub Issue Steals CI Secrets」2026年8月
- OWASP「Top 10 for Agentic Applications」2025年12月9日、「Top 10 for LLM Applications 2026」2026年8月4日
- Chroma Research「Context Rot: How Increasing Input Tokens Impacts LLM Performance」2025年
- Google Cloud / Mandiant「AI risk and resilience in 2026: A Mandiant special report」2026年
- Semperis「2026 Ransomware Risk Report」2026年10月14日
- 警察庁「令和8年上半期におけるサイバー空間をめぐる脅威の情勢等について」2026年9月10日
- パナソニック オペレーショナルエクセレンス株式会社「外部生成AIサービスへの個人情報アップロードに関するお詫びとお知らせ」2026年10月23日
- RIZAP株式会社 公表文 2026年9月3日
- Barracuda「Threat Spotlight: Email attacks target humans and AI in the same message」2026年10月7日
- Zenity Labs「AgentCorruption」2026年10月8日
- 経済産業省「AI事業者ガイドライン」
- Nexgen Japan「職務定義書サンプル AIスチュワード」Nexgen Report AI Governance Series